Le nombre de types d’API dépend entièrement du critère de classification retenu. Classer par protocole donne trois ou quatre familles. Classer par niveau d’exposition en produit autant. Croiser les deux axes multiplie les combinaisons. Il n’existe pas de nombre universel de types d’API, et toute réponse fixe (« il y a 4 types ») trahit une confusion entre taxonomies.
Protocoles d’API : au-delà du trio REST, SOAP, GraphQL
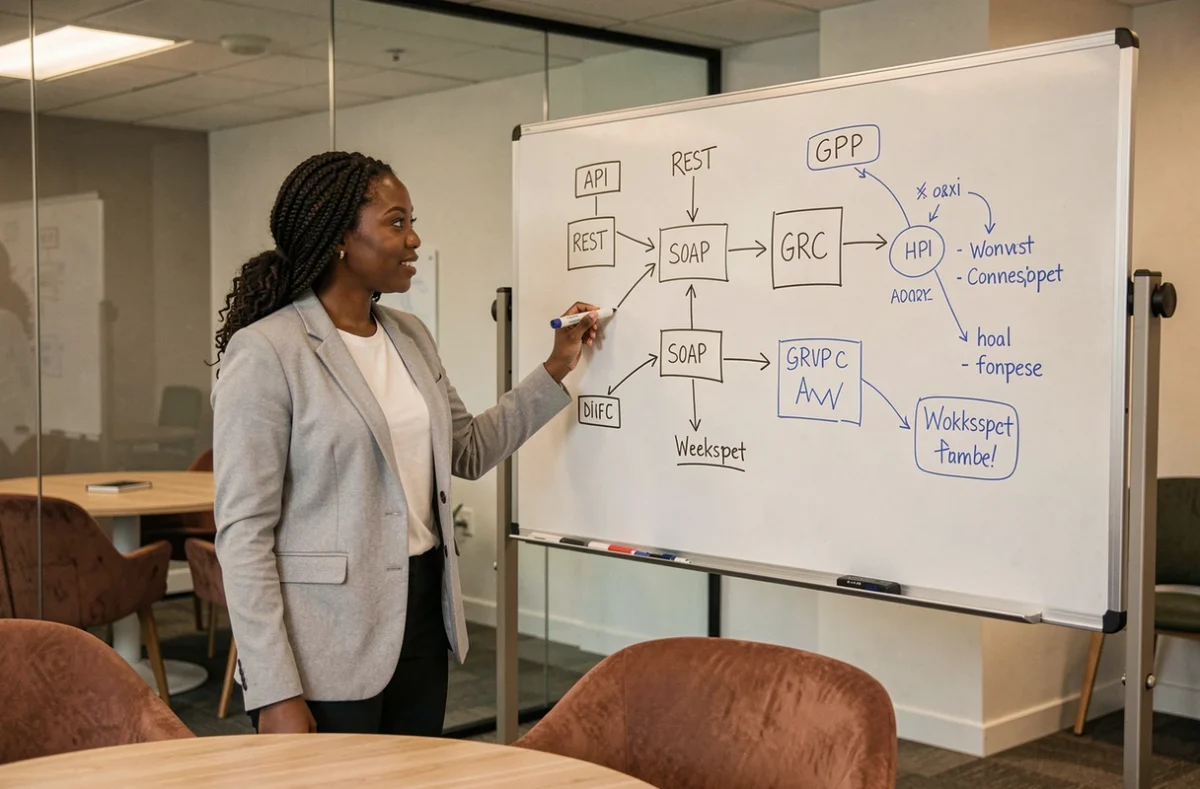
REST domine les échanges client-serveur sur HTTP depuis plus d’une décennie. Son modèle sans état, ses endpoints organisés autour de ressources et son format JSON en font le standard par défaut pour la majorité des applications web et mobiles.
A lire en complément : Pourquoi Wix n'est-il pas recommandé ?
SOAP reste présent dans les environnements où le contrat d’interface prime : banques, assurances, systèmes legacy. Le recours au XML, au WSDL et aux enveloppes standardisées garantit une validation stricte de chaque requete, au prix d’une verbosité que les équipes front évitent dès qu’elles le peuvent.
GraphQL ne remplace pas REST, il résout un problème différent : l’over-fetching. Le client décrit exactement la structure de données attendue, le serveur renvoie uniquement ce qui est demandé. En revanche, la gestion du cache et la sécurité par endpoint deviennent plus complexes, parce que chaque requete peut traverser le graphe de manière imprévisible.
A lire aussi : Comment inspecter le code d'un site Web ?
Deux autres protocoles méritent d’être mentionnés :
- gRPC, qui s’appuie sur HTTP/2 et Protocol Buffers pour des appels à faible latence entre microservices, avec génération automatique du code client et serveur
- Les API basées sur WebSocket, qui maintiennent une connexion persistante pour du temps réel (chat, streaming de données financières, notifications push)
Classification des API par niveau d’exposition et surface d’attaque
La distinction publique/privée/partenaire est connue. Ce qui l’est moins, c’est que cette classification correspond directement à un profil de risque en matière de sécurité.
Une API interne, exposée uniquement sur le réseau d’entreprise, tolère une authentification plus légère. Une API partenaire suppose un contrôle d’accès par clé ou token OAuth avec des scopes restreints. Une API publique, elle, constitue une surface d’attaque ouverte : chaque endpoint devient un vecteur potentiel d’abus.
Les API d’administration représentent le risque le plus élevé. Elles offrent des privilèges étendus (création de comptes, modification de configurations, accès aux logs) et sont souvent moins surveillées que les API orientées client. Nous observons régulièrement des architectures où l’API admin partage le même domaine et la même gateway que l’API publique, sans segmentation réseau.
API consommées par des agents autonomes
Une catégorie émergente mérite attention : les API destinées aux agents d’intelligence artificielle. Le protocole MCP (Model Context Protocol) permet à un agent de découvrir dynamiquement des outils et d’exécuter des actions via des serveurs spécialisés. Ce n’est plus un client humain qui appelle un endpoint connu, c’est un modèle qui orchestre des appels en chaîne.
Cette couche d’orchestration introduit des risques spécifiques. L’agent peut enchaîner des appels non prévus par le concepteur de l’API, et la traçabilité des actions devient difficile à garantir quand l’appelant n’est pas un utilisateur identifié mais un processus autonome.
API d’accès aux données IoT : le cadre réglementaire européen
Le règlement européen sur les données (Data Act) fait de l’API un mécanisme d’accès réglementé aux données des objets connectés. Les fabricants doivent exposer les données générées par leurs produits dans des formats lisibles par machine, avec des exigences de disponibilité et de sécurité.
Cette obligation crée une catégorie fonctionnelle distincte : l’API d’accès aux données IoT et industrielles. Elle ne se définit ni par son protocole (souvent REST), ni par son niveau d’exposition (partenaire ou publique selon les cas), mais par son cadre juridique. Les conditions d’accès, les délais de mise à disposition et les formats de réponse sont encadrés par le texte réglementaire, pas seulement par les choix techniques de l’éditeur.
Nous recommandons de traiter ces API comme une catégorie à part dans toute cartographie d’architecture, parce que les contraintes de conformité (auditabilité, non-discrimination entre consommateurs de données) s’ajoutent aux contraintes techniques classiques.
Choisir le bon type d’API pour son architecture
Le choix ne se pose pas en termes de « meilleur protocole ». Il se pose en termes de contraintes croisées : qui consomme l’API, quel volume de données transite, quelle latence est acceptable, et quel niveau de sécurité le contexte impose.
- Pour une intégration entre microservices internes avec forte volumétrie, gRPC offre des performances supérieures à REST grâce à la sérialisation binaire et au multiplexage HTTP/2
- Pour une API publique destinée à des développeurs tiers, REST avec documentation OpenAPI reste le choix le plus accessible et le mieux outillé
- Pour un frontend qui agrège des données de sources multiples, GraphQL réduit le nombre d’appels réseau et simplifie le code client
- Pour des échanges B2B avec validation contractuelle stricte, SOAP conserve un avantage structurel grâce au typage fort du WSDL
Pourquoi la classification unique n’existe pas
Un même endpoint peut être simultanément REST (protocole), partenaire (exposition), synchrone (pattern d’échange) et soumis au Data Act (cadre réglementaire). Ces quatre axes de classification se superposent sans s’exclure.
Toute cartographie d’API doit croiser au minimum le protocole, le niveau d’exposition et le contexte réglementaire. Se limiter à un seul axe revient à décrire une base de données uniquement par son moteur, sans mentionner le schéma ni les droits d’accès. Les équipes qui adoptent cette grille multi-axes identifient plus rapidement les failles de sécurité et les dettes d’intégration dans leur architecture.