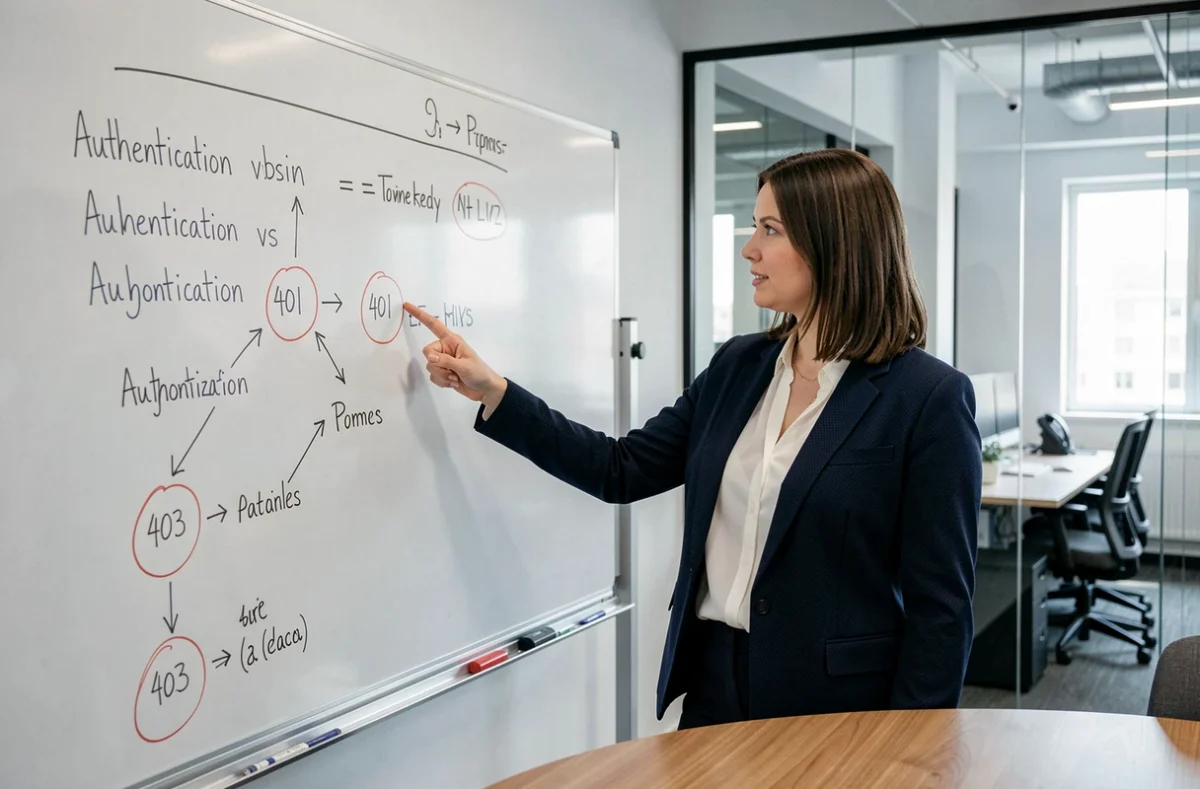
Les codes HTTP 401 et 403 signalent tous les deux un refus d’accès, mais ils ne décrivent pas le même problème. Le premier concerne l’authentification (le serveur ne sait pas qui vous êtes), le second concerne l’autorisation (le serveur sait qui vous êtes, mais vous refuse l’accès). Comprendre cette distinction évite des heures de débogage sur une API ou un site web.
Authentification et autorisation : deux mécanismes distincts
Avant de comparer les codes 401 et 403, il faut séparer deux concepts que le langage courant confond souvent. L’authentification répond à la question « qui êtes-vous ? ». Elle repose sur des identifiants : nom d’utilisateur, mot de passe, jeton (token) ou certificat.
A lire également : Pourquoi l'IA n'est pas fiable ?
L’autorisation intervient après. Une fois votre identité confirmée, le serveur vérifie vos droits : avez-vous la permission de lire cette ressource, de modifier ce fichier, d’appeler cet endpoint ? Un utilisateur peut être parfaitement authentifié et se voir refuser l’accès à une page précise.
Cette séparation est au coeur du protocole HTTP. Le code de réponse indique au client la nature exacte du blocage, ce qui oriente la marche à suivre.
A lire aussi : Comment régler l'espace entre le texte et la bordure ?
Code 401 Unauthorized : le serveur ne vous reconnaît pas
Le statut 401 signifie que la requête n’a pas été traitée parce que le client n’a pas fourni d’identifiants valides. Trois cas de figure déclenchent cette réponse :
- Aucun jeton ou header d’authentification n’accompagne la requête (l’utilisateur n’est tout simplement pas connecté).
- Le token transmis est expiré, révoqué ou malformé, ce qui revient, pour le serveur, à ne recevoir aucune preuve d’identité.
- Les identifiants (login et mot de passe) sont incorrects, typiquement lors d’un appel en Basic Auth.
Un point technique souvent ignoré : un serveur qui renvoie 401 doit inclure un en-tête WWW-Authenticate. Cet en-tête précise le mécanisme attendu, par exemple Basic ou Bearer. Cette obligation est définie dans la RFC 9110, publiée par l’IETF en juin 2022. Si votre serveur renvoie un 401 sans cet en-tête, le comportement côté client devient imprévisible.
Le nom officiel « Unauthorized » prête à confusion, car il suggère un problème d’autorisation. En réalité, le code 401 concerne exclusivement l’authentification. Retenir cette nuance évite de partir sur une fausse piste lors du diagnostic.
Code 403 Forbidden : accès refusé malgré l’identification
Le code 403 apparaît lorsque le serveur a compris la requête, éventuellement identifié le client, mais décide de refuser l’accès. Contrairement au 401, renvoyer de nouveaux identifiants ne changera rien : le blocage est volontaire et permanent (tant que les droits ne sont pas modifiés).
La RFC 9110 précise un point que les concurrents mentionnent rarement : un 403 ne signifie pas forcément que le client est authentifié. L’interdiction peut venir d’une règle de pare-feu, d’un filtrage anti-robot, d’une restriction géographique ou d’une politique réseau. Le serveur refuse la requête sans même chercher à vérifier l’identité du demandeur.
Cas fréquents déclenchant un 403
- Un utilisateur connecté tente d’accéder à un panneau d’administration réservé à un rôle supérieur.
- Un appel API utilise un token valide, mais dont le périmètre (scope) ne couvre pas la ressource demandée, comme décrit dans la RFC 6750.
- Un serveur web bloque l’accès à un répertoire parce que les permissions fichier (chmod) interdisent la lecture.
- Un WAF ou un reverse proxy rejette la requête sur la base de l’adresse IP ou du User-Agent.
Dans tous ces cas, le serveur ne renvoie pas d’en-tête WWW-Authenticate. Il n’invite pas le client à s’authentifier autrement, car le problème ne se situe pas à ce niveau.
Erreur 401 vs 403 dans une API OAuth avec bearer tokens
La confusion entre 401 et 403 atteint son pic dans les architectures utilisant OAuth 2.0. La RFC 6750 donne une règle de tri claire :
Si le jeton est absent, expiré ou invalide, le serveur renvoie un 401 avec un challenge Bearer. Le client sait qu’il doit obtenir un nouveau token (par exemple via un refresh token) avant de retenter l’appel.
Si le jeton est valide mais que le scope accordé ne couvre pas la ressource, le serveur renvoie un 403. Aucun rafraîchissement de token ne résoudra le problème : il faut demander un scope plus large ou modifier les droits côté serveur.
Cette logique s’applique de la même façon aux clés API. Une clé mal formée ou révoquée produit un 401. Une clé active mais rattachée à un plan tarifaire qui n’inclut pas l’endpoint demandé produit un 403.
Quand un serveur renvoie 404 au lieu de 403
La RFC 9110 autorise une pratique qui surprend au premier abord : un serveur peut renvoyer 404 pour masquer l’existence d’une ressource protégée. Renvoyer un 403 confirme implicitement que le fichier ou l’endpoint existe, ce qui peut constituer une fuite d’information exploitable.
Sur une API exposée publiquement, cette technique réduit la surface d’attaque. Un attaquant qui énumère des chemins d’URL ne peut plus distinguer une ressource inexistante d’une ressource protégée. En revanche, côté débogage interne, cette pratique complique le diagnostic. Documenter ce comportement dans la spécification de l’API reste la meilleure approche.
Diagnostic rapide : 401 ou 403, par où commencer
Face à un refus d’accès, vérifiez d’abord le code exact renvoyé dans la réponse HTTP, pas le message affiché dans le navigateur (qui peut être personnalisé et trompeur).
Pour un 401, contrôlez la présence et la validité du token ou des identifiants. Vérifiez aussi que l’en-tête Authorization est correctement formaté (une simple coquille dans le préfixe « Bearer » suffit à provoquer le rejet). Inspectez enfin l’en-tête WWW-Authenticate de la réponse : il indique le mécanisme attendu par le serveur.
Pour un 403, le problème se situe côté droits. Vérifiez le rôle de l’utilisateur, le scope du token, les permissions fichier sur le serveur et les éventuelles règles de filtrage réseau. Si le 403 survient sans authentification préalable, un pare-feu ou un proxy est probablement en cause.
Un dernier réflexe utile : si la ressource n’est pas censée révéler son existence aux utilisateurs non autorisés, considérez le remplacement du 403 par un 404, conformément aux recommandations de la RFC 9110. Le choix entre transparence et sécurité dépend du contexte applicatif, mais il doit être explicitement documenté dans la politique de réponse de l’API.